上周开了个技术评审会。
一个年轻的后端同事,用了三天,提交了一个 2000 行的 PR。
他说,“大部分是 AI 写的,我调了调。”
我看着那个 PR,沉默了很久。
2000 行。
三天。
搁五年前,这种工作量至少两周。
但我的第一反应不是"真快"。
是"谁来审?"
这个问题,最近一直在我脑子里转。
因为我看到了一组数据,来自 Faros AI 的报告。
他们追踪了 22000 个开发者,4000 个团队。
2026 年的数据,很好看:
每个开发者完成的 epic 数量涨了 66%。
任务吞吐量涨了 34%。
AI 生成的代码,开发者直接接受不改的比例,从 20% 涨到了 60%。
听起来很美对吧?
AI 真的让开发变快了。
但报告里还有一句话,被大多数人忽略了:
代码审查成了最大的瓶颈。
不是"之一"。
是"最大的"。
我做了 18 年开发,头一次看到"代码审查"被放到这种位置。
以前我们聊瓶颈,聊的是什么?
需求不清晰。
架构设计有问题。
测试覆盖不够。
部署流程太慢。
代码审查?那是个"锦上添花"的环节。
有空就审,没空就 LGTM。
现在不一样了。
现在代码审查是"生死关口"。
为什么?
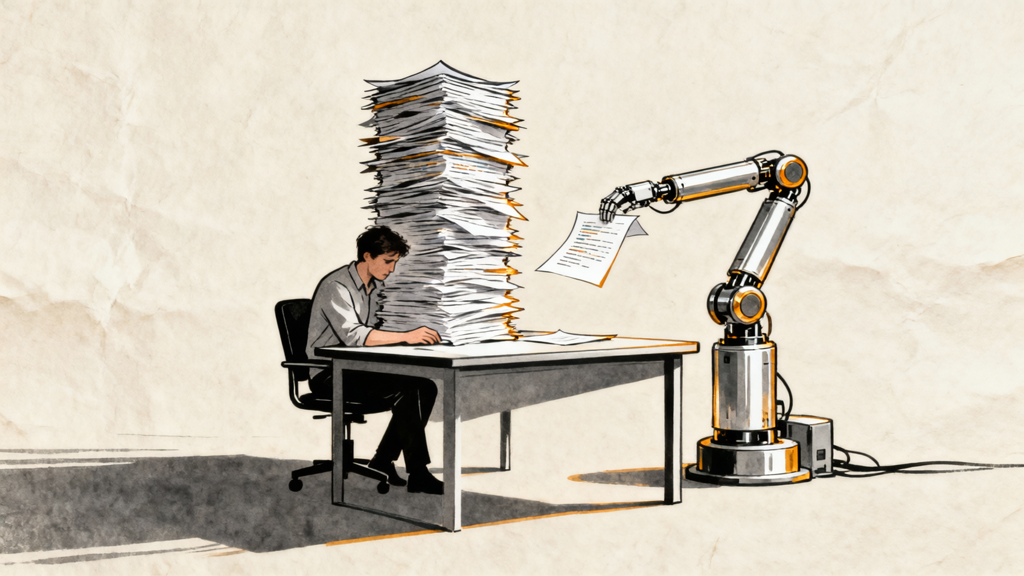
因为 AI 改变了代码生产的速度,但没有改变代码审查的速度。
LinearB 的数据说得很直白:
AI 辅助的 PR,审查者开始看的时间,是普通 PR 的 5.3 倍。
5.3 倍。
什么意思?
就是你用 AI 写了一个 PR,提交上去,然后等。
等很久。
因为审查你的人,手头可能还有三个 AI 写的 PR 在排队。
每个人都在用 AI 写代码。
但审代码的还是人。
人的速度没变。
CircleCI 的数据更扎心。
他们分析了 2800 万次 CI 运行。
2026 年的结果:
feature 分支的吞吐量涨了 59%。
但主分支的吞吐量,降了 7%。
主分支的成功率,掉到了 70.8%。
你品品这个数字。
分支上写得飞快。
合并到主分支?慢了。
还更容易出问题了。
为什么?
因为中间隔着一个环节:审查。
代码写得快,不代表代码是对的。
AI 生成的代码,看起来逻辑通顺、格式漂亮、注释齐全。
但它可能在第 800 行埋了一个并发问题。
在第 1500 行用了一个已废弃的 API。
在某个边界条件下会静默失败。
这些东西,不仔细看,看不出来。
Sonar 做了一个调查,1100 多个开发者。
结果很有意思:
42% 的已提交代码是 AI 生成的。
预计 2027 年会到 65%。
但 96% 的开发者不完全信任 AI 生成的代码。
只有 48% 的人每次都验证。
你看到矛盾了吗?
代码越来越多是 AI 写的。
但大多数人不敢完全信它。
而且一半的人不验证就提交了。
这意味着什么?
意味着大量未经验证的 AI 代码,正在流入生产环境。
我说一个我自己的经历。
上个月,团队里一个同事用 Claude Code 重构了一个支付模块。
代码写得很漂亮。
测试也过了。
我审的时候,差点就 LGTM 了。
但多看了一眼。
发现他在处理退款逻辑的时候,用了一个 try-catch 把异常吞掉了。
没有日志。
没有告警。
就是静默失败。
如果这笔退款在线上出了问题,没人会知道。
直到用户投诉。
我问他:“这里为什么这样写?”
他说:“AI 生成的,我觉得挺合理的,就没细看。”
挺合理的。
就没细看。
这六个字,让我后背发凉。
我不是说 AI 不好。
我自己每天都在用。
写脚本、查文档、生成样板代码、甚至写一些简单的业务逻辑。
确实快。
确实爽。
但有一个心态上的陷阱:
当你习惯了 AI 给你的代码"看起来都对",你就会放松警惕。
这是人的本能。
当你连续审了十个 PR,每个都看起来没问题,你的大脑会自动降低审查强度。
“应该没事吧。”
“看起来挺合理的。”
“AI 写的应该不会犯这种低级错误。”
然后错误就藏在"应该"和"看起来"里面。
Faros AI 的报告里还有一个数字:
AI 生成代码的开发者接受率,从 20% 涨到了 60%。
也就是说,六成代码,开发者看都不看就直接收了。
我理解这种效率诱惑。
谁不想快点下班呢?
但代码不是外卖。
你不能"确认收货"就完事了。
它要在生产环境跑。
要在凌晨三点出问题时有人能排查。
要在半年后有人能维护。
所以我觉得,2026 年开发者面临的最大挑战,不是"怎么用 AI 写代码"。
而是"怎么审 AI 写的代码"。
这两件事需要的能力完全不同。
写代码,你需要的是表达能力——把需求翻译成机器能懂的指令。
审代码,你需要的是怀疑能力——在看起来合理的东西里找到不合理。
前者 AI 越来越强。
后者,目前只有人能做好。
而且审代码的人,需要比写代码的人更有经验。
这就是为什么"代码审查成了最大瓶颈"。
不是审查的人不够多。
是审查需要的能力门槛,比大多数人想象的高。
我后来跟团队定了个规矩:
AI 生成的代码,审查标准翻倍。
不是减半。
是翻倍。
因为 AI 写的代码,最大的问题不是"写错了"。
是"写对了,但在你看不到的地方写错了"。
它不会犯语法错误。
不会犯类型错误。
它会犯的是逻辑错误、边界错误、并发错误。
这些错误,比语法错误难发现十倍。
回到开头那个 2000 行的 PR。
我审了两天。
发现了 7 个问题。
3 个是潜在的并发问题。
2 个是边界条件没处理。
1 个是用了已废弃的库。
1 个是业务逻辑理解偏差。
同事说:“我以为 AI 写的应该没什么问题。”
我说:“AI 写的代码,最大的问题就是让你觉得它没什么问题。”
写完这篇文章,我看了看自己的代码提交记录。
上个月,我写的代码里有大概 35% 是 AI 辅助的。
我审别人的 PR 时,会特别留意那些"太顺滑"的代码。
太顺滑,往往意味着有问题。
因为真正没问题的代码,不会那么顺滑。
它会有一些"笨拙"的地方。
一些显式的错误处理。
一些看起来多余的日志。
一些"不必要"的边界检查。
这些东西,是经验的痕迹。
是踩过坑的人留下的护栏。
AI 不会写这些。
因为 AI 没踩过坑。
所以,如果你也在用 AI 写代码,我给你一个建议:
下次 AI 给你一段代码,你觉得"挺合理的"时候——
停下来。
多看一眼。
再问一句"为什么"。
那个让你觉得"挺合理"的瞬间,恰恰是你最需要警惕的瞬间。
代码审查从来不是锦上添花。
只是以前,我们还有余裕忽略它。
现在,没有余裕了。