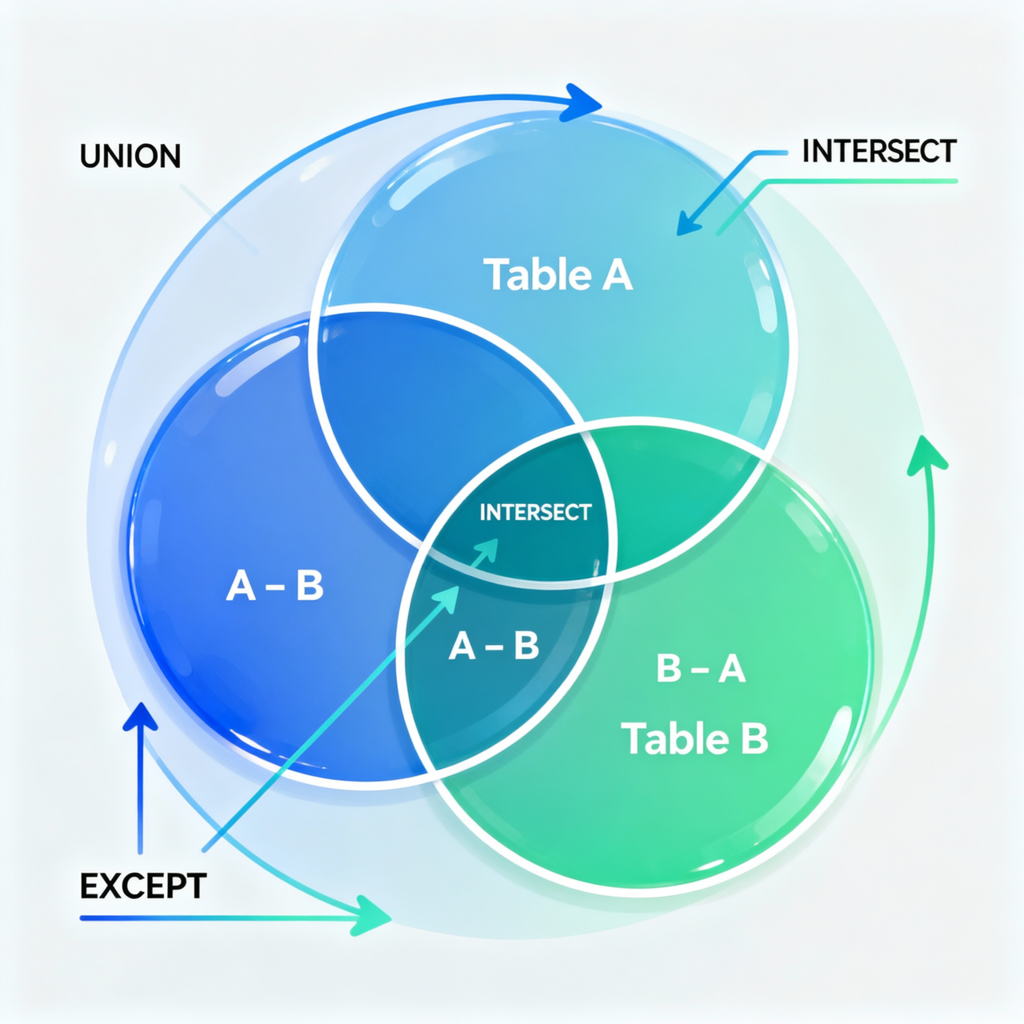
处理多表数据合并时,集合操作是绕不开的基础工具。UNION、INTERSECT、EXCEPT 这些 SQL 标准语法,在 DuckDB 里有些特别的表现。
这篇文章会拆解四种集合操作的用法,分享一些真实的性能测试数据,还有 DuckDB 独有的 UNION BY NAME 功能。如果你正在用 DuckDB 做多源数据整合,这些内容应该能帮上忙。
四种集合操作速览
先理清基本概念。SQL 标准定义了四种集合操作,DuckDB 全部支持:
UNION - 合并两个查询结果,自动去重
UNION ALL - 合并两个查询结果,保留重复行
INTERSECT - 取两个查询结果的交集
EXCEPT - 取第一个查询结果减去第二个(差集)
语法都很简单:
看起来 straightforward,但实际用起来有些细节值得注意。
性能差异:UNION vs UNION ALL
很多人可能没意识到,UNION 和 UNION ALL 的性能差距可以非常大。
UNION 需要去重,DuckDB 会用哈希表来做这件事。数据量小的时候感觉不到,数据量一大,差距就明显了。
我在本地跑了一组测试,数据量从 1 万行到 50 万行,两个表有 50% 的数据重叠:
| 数据量 | UNION ALL | UNION | INTERSECT | EXCEPT |
|---|---|---|---|---|
| 10,000 | 0.0007s | 0.0031s | 0.0026s | 0.0023s |
| 50,000 | 0.0005s | 0.0088s | 0.0066s | 0.0066s |
| 100,000 | 0.0005s | 0.0154s | 0.0109s | 0.0116s |
| 500,000 | 0.0007s | 0.0546s | 0.0394s | 0.0370s |
几个关键观察:
UNION ALL 的性能非常稳定,基本不受数据量影响,始终在 0.0005-0.0007 秒这个量级。因为它只是简单拼接,不需要额外处理。
UNION、INTERSECT、EXCEPT 的性能都随数据量线性增长。到 50 万行时,UNION 比 UNION ALL 慢了大约 78 倍(0.0546s vs 0.0007s)。INTERSECT 和 EXCEPT 的性能表现相近。
选择建议:如果你确定两个结果集没有重复数据,或者你不在乎重复,用 UNION ALL。如果需要去重,再考虑 UNION。大数据量场景下,这个选择对性能影响很大。
UNION BY NAME:DuckDB 的特色功能
这是 DuckDB 相比传统数据库的一个实用扩展。
标准 UNION 要求两个查询的列数完全一致,而且按位置对齐。如果列顺序不同,或者列数不一样,就会报错。
UNION BY NAME 改变了这个规则。它按列名对齐,而不是按位置。缺失的列会自动填充 NULL。
| |
结果会有 6 列:date_str、quantity、price、timestamp、qty、unit_price。csv_data 的行在 timestamp/qty/unit_price 列是 NULL,api_data 的行在 date_str/quantity/price 列是 NULL。
这个特性在几个场景下特别有用:
场景 1:合并不同来源的数据
比如你要合并 CSV 文件和 API 返回的数据,两边的字段命名可能不一样。UNION BY NAME 可以自动处理这种差异。
场景 2:多文件批量导入
即使不同年份的 CSV 列顺序不同,也能正确合并。
场景 3:增量数据合并
新增的表可能比旧表多几个字段,UNION BY NAME 可以无缝处理。
不过要注意,NULL 填充可能带来后续处理的问题。如果业务逻辑依赖这些字段,最好在合并前先统一列名,或者用 COALESCE 处理 NULL 值。
实战案例
案例 1:找出流失客户
用 EXCEPT 找出上个季度活跃但这个季度没购买的客户:
这个查询会返回在上季度活跃但本季度没有购买记录的客户 ID。
案例 2:识别 VIP 客户
用 INTERSECT 找出同时满足多个条件的客户:
结果是既消费金额高、又购买频次高的客户,这就是你的核心 VIP 群体。
案例 3:合并多季度销售数据
用 UNION ALL 合并多个季度的数据,保留所有记录:
这里用 UNION ALL 而不是 UNION,因为我们不需要去重(每个季度的数据本身就是独立的),而且 UNION ALL 更快。
案例 4:合并异构数据源
用 UNION BY NAME 合并结构不完全一致的数据:
线上渠道没有 staff_count 字段,UNION BY NAME 会自动为这些行填充 NULL。
常见踩坑点
坑 1:列数不一致报错
标准 UNION/INTERSECT/EXCEPT 要求两个查询的列数完全一致。如果列数不同,会直接报错。
解决方案有两个:要么补齐列数,要么用 UNION BY NAME。
坑 2:类型不匹配
两个查询的对应列类型不一致时,DuckDB 会尝试隐式转换。有时候能成功,有时候会报错或者产生意外结果。
养成显式转换的习惯,可以减少很多奇怪的问题。
坑 3:UNION 的性能陷阱
前面提到过,UNION 比 UNION ALL 慢很多。如果你只是简单合并数据,不需要去重,用 UNION ALL。
如果确实需要去重,可以考虑先 UNION ALL,再用 DISTINCT 或者 GROUP BY 处理,这样逻辑更清晰,有时候性能也更好。
坑 4:UNION BY NAME 的 NULL 填充
UNION BY NAME 会为缺失列填充 NULL。如果后续查询没有处理这些 NULL,可能会出问题。
| |
选择决策树
面对具体场景时,可以这样选择:
需要合并两个查询结果?
- 确定没有重复,或者不在乎重复 → UNION ALL(最快)
- 需要去重 → UNION
需要找共同数据?
- 两个结果集的交集 → INTERSECT
需要找差异数据?
- 第一个结果集减去第二个 → EXCEPT
两个查询的列结构不一致?
- 用 UNION BY NAME(DuckDB 特色)
总结
DuckDB 的集合操作遵循 SQL 标准,但有一些实用的扩展。UNION BY NAME 在处理异构数据源时特别有用,可以省去很多手动对齐列的工作。
性能方面,记住一个原则:能用 UNION ALL 就不用 UNION。去重的开销在大数据量下会很明显。
集合操作经常和 CTE、JOIN 一起使用,组合起来可以处理很复杂的数据整合场景。如果你对这些高级用法感兴趣,可以看看 DuckDB 官方文档里的更多示例。